블로그 · 2026년 9월 21일 · 읽기 14분
Next.js 공식 저장소에 PR 두 개를 머지했다: 오픈소스에 기여한 이야기
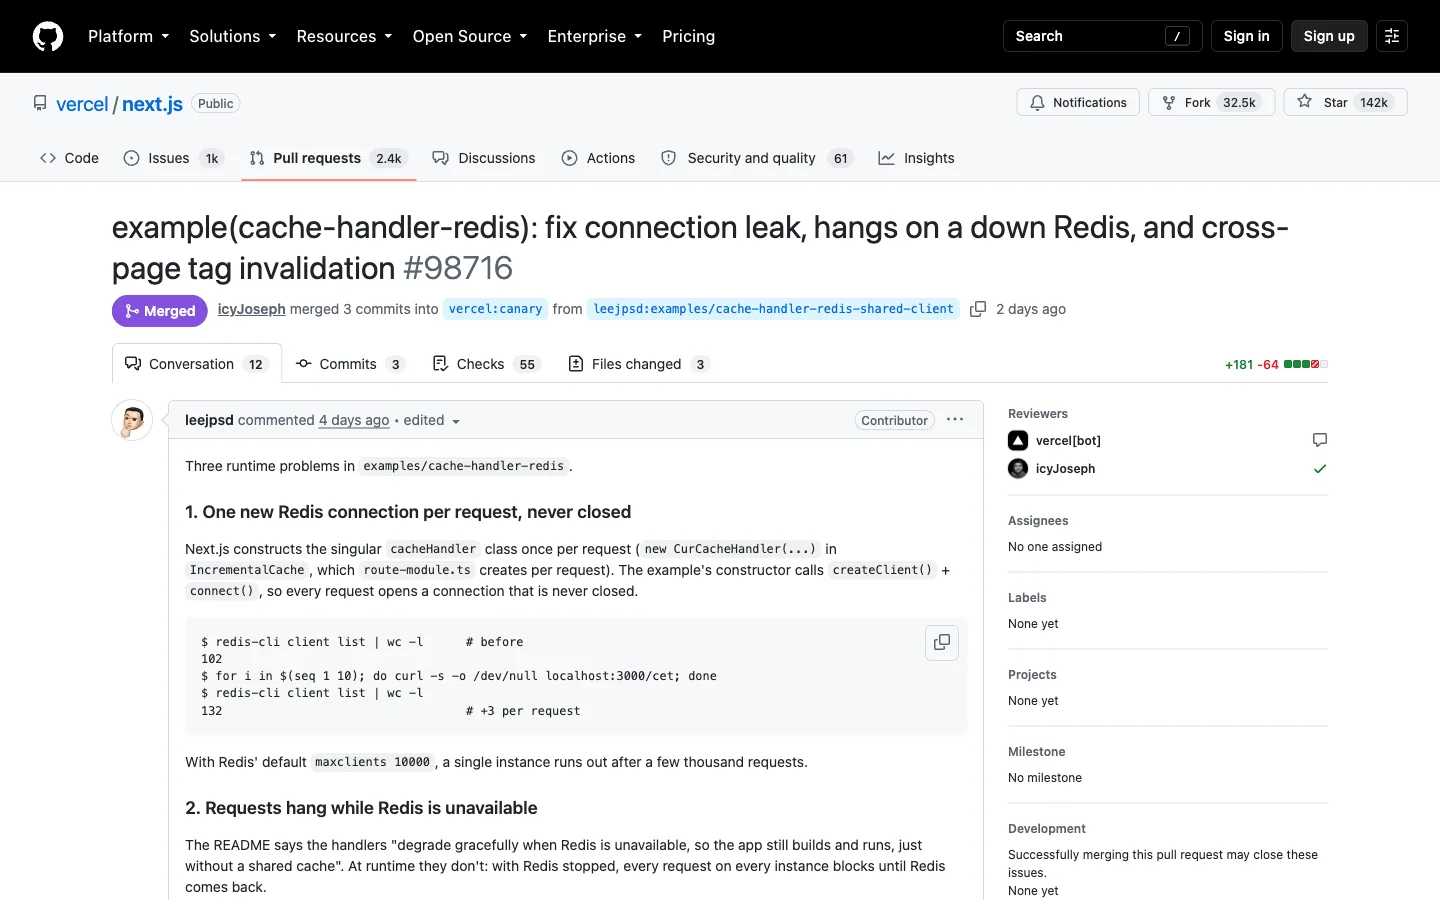
Next.js 저장소에 PR 두 개를 머지했다. 하나는 어댑터 문서에서 빠진 필드 두 개를 채운 것이고, 다른 하나는 공식 Redis 캐시 핸들러 예제의 런타임 버그 세 건을 고친 것이다.
둘 다 "오픈소스에 기여해 보자"는 마음으로 저장소를 뒤져서 찾은 게 아니다. 내 일을 하다가 걸린 것들이다. 어댑터를 직접 만들다가 문서에 없는 필드를 만났고, 멀티 인스턴스 캐시를 붙이다가 공식 예제를 읽었는데 그대로 쓰면 안 되겠다는 판단이 들었다.
과정을 그대로 적는다. 특히 두 번째는 리뷰를 받으면서 처음 낸 진단보다 더 큰 문제가 드러난 경우라, 리뷰어와 주고받은 내용을 거의 다 옮겼다.
1부 — 타입에는 있는데 문서에는 없는 필드 두 개
어댑터를 직접 만들고 있었다
Next.js 16에는 빌드 결과를 받아 배포 플랫폼에 맞게 가공하는 어댑터 API가 있다. onBuildComplete 훅으로 라우팅 정보와 출력물 목록을 받는다. 자체 호스팅 환경에 맞는 어댑터가 필요해서 16.3.0-canary.107을 기준으로 직접 짜고 있었다.
문서를 보면서 만들다가, 실제로 받은 객체를 찍어 봤다. 문서에 없는 필드가 두 개 있었다.
assetsHashes — 다섯 개 출력 타입 전부에 있는데 어디에도 안 적혀 있다
빌드가 끝나면 PAGES, PAGES_API, APP_PAGE, APP_ROUTE, MIDDLEWARE 다섯 종류의 출력이 나온다. 각각 추적된 의존 파일 목록인 assets를 들고 있는데, 그 바로 옆에 assetsHashes가 같이 있었다. 각 파일의 내용 해시다.
내용 해시는 같은 파일을 다시 올리지 않으려는 배포 도구에 쓸모가 있는 값이다. 그런데 문서의 다섯 출력 타입 어디에도 이 필드가 없었다. Next.js가 배포하는 타입 선언(build-complete.d.ts)에는 주석까지 달려 있는데 문서만 비어 있었다.
routing.middlewareMatchers — 아홉 개 중 여덟 개만 적혀 있었다
onBuildComplete에서 받은 routing 객체를 그대로 찍으면 이렇게 나온다.
afterFiles, beforeFiles, beforeMiddleware, dynamicRoutes, fallback,
middlewareMatchers, onMatch, rsc, shouldNormalizeNextData
아홉 개다. 그런데 문서는 여덟 개만 설명하고 있었다. 빠진 하나가 middlewareMatchers다. 게다가 이 인터페이스가 나오는 곳이 세 군데인데(어댑터 만들기 페이지의 "인터페이스는 다음과 같이 정의된다"는 코드 블록, API 레퍼런스의 파라미터 목록, 라우팅 정보 페이지) 세 곳 모두 빠져 있었다.
이건 단순한 누락보다 조금 더 성가신 문제라고 봤다. 어댑터가 요청 매칭을 직접 구현하려면 "이 요청에 미들웨어를 돌려야 하나"를 판단해야 하는데, 문서에 적힌 필드만 가지고는 그걸 결정할 방법이 없다.
왜 아무도 안 걸렸을까
PR을 올리기 전에 이 질문을 먼저 정리했다. 나만 이상한 걸 겪었다면 내가 잘못 쓰고 있을 가능성이 크기 때문이다.
답은 이랬다. @next/routing의 resolveRoutes에 routes: routing을 통째로 넘기면, 그 안에서 알아서 처리한다. 필드를 하나씩 들여다볼 일이 없으니 빠진 줄도 모른다. 나처럼 매칭을 직접 구현하려는 경우에만 걸린다.
고치고, 확인하고, 올렸다
문구는 내가 지어내지 않고 Next.js가 배포하는 타입 선언의 주석을 그대로 옮겼다. 위치도 타입이 놓은 자리와 맞췄다(beforeMiddleware 바로 다음). 문서와 코드가 어긋나서 생긴 문제를 고치는 PR인데 설명을 새로 지어내면 같은 문제를 반복하는 셈이다.
올리기 전에 같은 빌드를 기준으로 어댑터 섹션 전체를 한 번 훑었다. output: 'export' 동작, 프리렌더 분류 필드, pprChain.headers, 폴백 관련 필드, 불변 정적 자산 흐름, @next/routing의 파라미터와 반환값까지 확인했고 나머지는 문서와 일치했다. PR 본문에 "이 두 개가 내가 찾은 전부"라고 적었다.
21일 뒤에 머지됐다. 지금 output-types와 routing-information 문서에 그 두 줄이 올라가 있다.
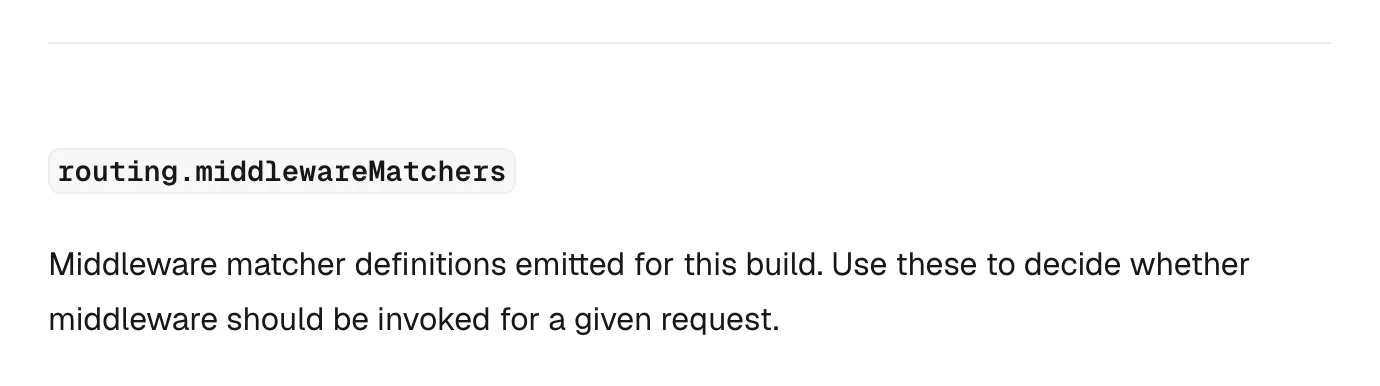
빠져 있던 아홉 번째 필드. 설명 문구는 배포되는 타입 선언의 주석을 그대로 옮겼다.
첫 기여로 문서를 고른 건 의도한 게 아니었지만 결과적으로 괜찮은 선택이었다. 저장소 규칙과 PR 흐름을 한 번 겪어 보고, 다음 PR을 올릴 때 부담이 줄었다.
2부 — 공식 예제를 그대로 쓰면 안 되겠다고 판단한 순간
발단
멀티 인스턴스 Next.js의 캐시 무효화를 Redis로 공유하는 작업을 하고 있었다. Next.js 저장소에 있는 공식 예제 examples/cache-handler-redis가 기준점이라 읽어 봤는데, 읽다가 손이 멈췄다.
module.exports = class CacheHandler { constructor(options) { this.client = createClient({ url: process.env.REDIS_URL }) // ... this.connection = this.client.connect() }
생성자에서 클라이언트를 만들고 연결한다. 그런데 Next.js는 이 클래스를 요청마다 새로 생성한다. IncrementalCache가 요청마다 만들어지고, 그 안에서 new CurCacheHandler(...)를 부른다.
의심은 쉬운데 확인은 해야 한다. 예제를 띄우고 세어 봤다.
$ redis-cli client list | wc -l # 요청 전 102 $ for i in $(seq 1 10); do curl -s -o /dev/null localhost:3000/cet; done $ redis-cli client list | wc -l 132 # 요청당 +3
요청 10번에 연결 30개가 늘었고, 하나도 닫히지 않았다. Redis 기본 maxclients가 10,000이니 인스턴스 하나가 요청 수천 건이면 한도에 닿는다.
두 번째 버그 — Redis가 죽으면 요청도 죽는다
예제 README에는 이렇게 적혀 있다.
Redis를 쓸 수 없을 때도 우아하게 저하되므로, 공유 캐시만 없을 뿐 앱은 계속 빌드되고 실행된다.
실제로는 그렇지 않았다.
$ docker stop cache-handler-redis $ curl -s -o /dev/null -m 60 -w "%{http_code} %{time_total}s\n" localhost:3000/cet 000 60.007305s
60초 제한을 걸었더니 그대로 끝까지 갔다. 제한을 풀고 다시 하니 188초를 기다렸고, 응답이 돌아온 시점은 내가 Redis를 다시 켠 바로 그 순간이었다. 캐시가 없어서 느린 게 아니라, 캐시를 기다리느라 멈춰 있었던 것이다.
원인은 node-redis의 동작에 있었다. 최소 코드로 떼어내 확인했다.
const c = createClient({ url: "redis://localhost:6379" }); c.on("error", () => {}); await Promise.race([c.connect(), new Promise(r => setTimeout(() => r("pending"), 15000))]); // -> 15초 뒤 "pending", isOpen=true isReady=false (redis@6.2.1)
connect()는 연결에 성공할 때까지 끝나지 않는다. 백그라운드에서 계속 재시도할 뿐이다. 예제는 요청마다 새 핸들러를 만들고, 그 핸들러가 매번 새로 이 약속을 기다렸다. 그래서 모든 요청이 멈췄다.
두 버그는 원인이 하나였다. 클라이언트가 요청 단위로 살아 있다는 것.
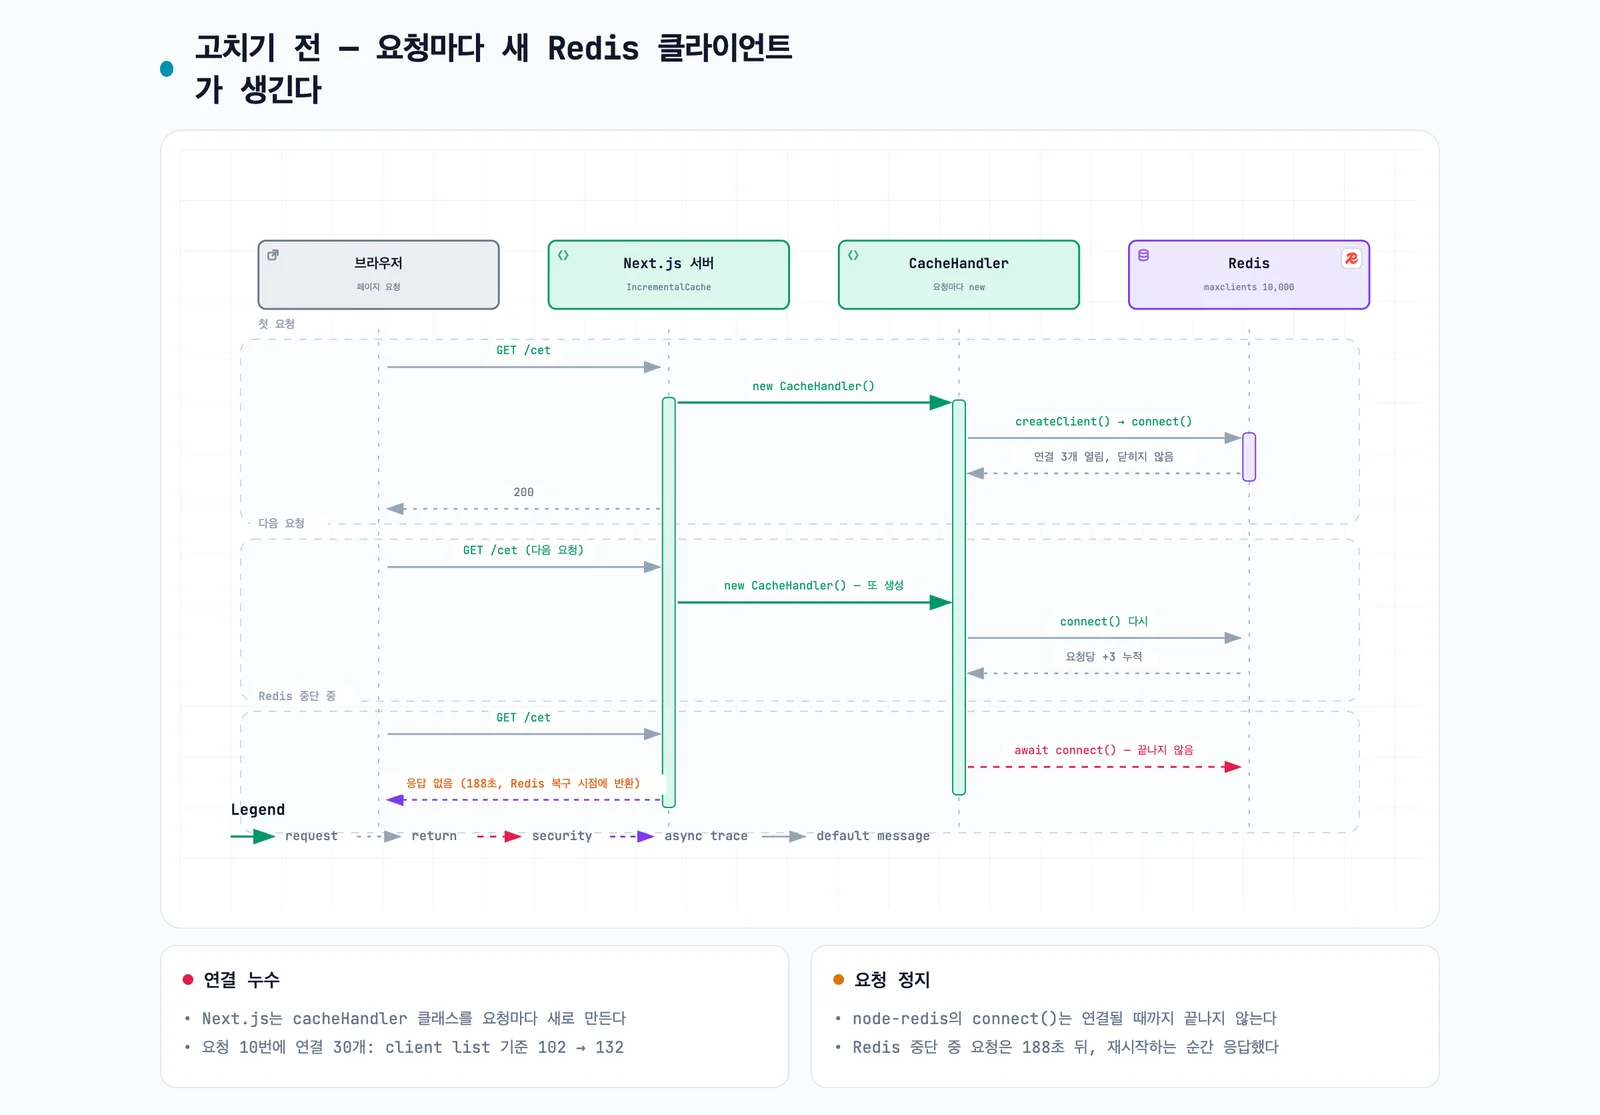
요청마다 핸들러가 새로 생기니 연결도 새로 열리고, 연결을 기다리는 약속도 매번 새로 생긴다.
1차 수정과 첫 리뷰
클라이언트를 모듈 최상단으로 올리고(같은 저장소의 remote 핸들러가 이미 쓰던 방식이다), 연결을 기다리는 대신 isReady를 확인하게 고쳤다. 연결이 끊겨 있을 때 명령이 큐에 쌓이지 않도록 disableOfflineQueue도 켰다.
리뷰어는 Vercel 멤버인 icyJoseph였다. 오픈 당일에 코멘트가 세 개 달렸다.
첫 번째는 동의였다.
Ok so good on the singleton approach, let's keep that.
두 번째는 반대였다. 내가 연결 대기를 없앤 게 문제라고 했다.
getClient()가isReady전까지null을 돌려주면, 연결이 맺어지는 창에 들어온 모든 요청이 읽기 미스이자 쓰기 누락이 된다. 로컬에서는 괜찮을지 몰라도 프로덕션에서는 그 창이 너무 클 수 있다.
맞는 지적이었다. 나는 "Redis가 죽었을 때 멈추지 않는 것"만 보고 "시작 직후 정상적으로 연결 중인 순간"을 같이 버렸다. 대안으로 그가 제시한 건 연결 약속과 타이머를 경주시키는 방식이었다. 그리고 한 줄을 덧붙였다.
타이머에
.unref()가 있어야 프로세스가 붙잡히지 않는다.
세 번째는 try/catch 범위였다. 내가 메서드 전체를 감쌌는데, 그러면 역직렬화 실패까지 "Redis 장애"로 둔갑한다는 지적이었다.
셋 다 반영했다. 그 결과가 이렇다.
const connection = process.env.NEXT_PHASE === PHASE_PRODUCTION_BUILD ? Promise.resolve() : client.connect().catch((error) => { console.warn("Failed to connect to Redis:", error); }); // `connect()`는 Redis가 닿지 않는 동안 끝나지 않으므로 대기에 상한을 둔다. const CONNECT_TIMEOUT_MS = 1000; const ready = Promise.race([ connection, new Promise((resolve) => setTimeout(resolve, CONNECT_TIMEOUT_MS).unref()), ]); async function getClient() { await ready; return client.isReady ? client : null; }
리뷰어의 한 줄이 실험으로 이어졌다
같은 리뷰에 이런 질문이 있었다.
Also the way things have been refactored, also toss away revalidate methods right?
리팩터링하면서 무효화 관련 메서드의 오류까지 삼켜 버린 것 아니냐는 뜻이다. 다시 보니 그랬다. revalidateTag와 updateTags에서 예외를 삼키면 무효화가 실패해도 아무도 모른다. getExpiration이 오류에 0을 돌려주는 것도 "한 번도 무효화된 적 없음"으로 읽힌다.
세 곳에서 try/catch를 걷어냈다. 그런데 하나가 남았다. Redis에 아예 연결되지 않은 상태에서 무효화 요청이 들어오면 어떻게 할 것인가. 그냥 return할 것인가, 예외를 던질 것인가.
말로 정하기보다 돌려 보는 게 빨랐다. 인스턴스 두 대를 Redis 하나에 붙이고, Redis를 내린 상태에서 Revalidate를 눌렀다. 이때 중요한 건 Redis를 멈추기 전에 SAVE를 해 두는 것이다. 처음엔 그냥 docker stop으로 했다가 데이터가 날아가서, 복구 후 캐시가 비어 있는 걸 "무효화가 반영됐다"고 잘못 읽을 뻔했다.
return | throw | |
|---|---|---|
| Revalidate 클릭 | 액션 200, 화면에 새 시각 02:41:42 | 액션 500, Redis unavailable 로그, 화면은 정상 |
| Redis 복구 후 | 장애 이전 값 02:41:16을 다시 내보냄 | 장애 이전 값을 다시 내보냄 |
둘 다 무효화를 살리지는 못한다. 차이는 사용자가 그 사실을 아는가에 있다. return이면 화면은 성공이라고 말하고, Redis가 돌아온 뒤 시각이 거꾸로 간다. 이 표를 그대로 PR에 올리고, 나는 throw 쪽으로 기운다고 적었다. remote 핸들러의 기존 동작까지 바꾸는 일이라 결정은 리뷰어에게 넘겼다.
봇의 지적을 확인하다가 더 큰 버그를 찾았다
며칠 뒤 Vercel의 리뷰 봇이 코멘트를 달았다. getExpiration에 오류 처리가 없어서, 일시적인 연결 실패가 캐시 미스가 아니라 렌더링 실패가 된다는 내용이었다.
확인해 보니 그 함수는 canary와 한 줄도 다르지 않았다. 봇은 내 첫 커밋과 비교하고 있었다. 그리고 봇이 암시한 수정(오류를 잡아서 0 반환)은 실제로는 캐시 미스가 아니다. Next.js는 entry.timestamp <= expiration일 때만 캐시를 버리므로, 0은 "무효화된 적 없음"으로 읽혀서 이미 무효화된 캐시를 그대로 내보낸다.
여기까지는 반박이면 끝날 일이었다. 그런데 근거를 확인하려고 Next.js가 getExpiration을 언제 부르는지 소스를 따라가다가 다른 걸 봤다.
getExpiration에는 경로에서 파생된 암묵적 태그만 넘어온다. cacheTag로 붙인 진짜 태그는 넘어오지 않는다. 그럼 캐시에 붙은 태그는 누가 확인하는가. 기본 핸들러는 get 안에서 직접 확인한다. 그런데 예제의 remote 핸들러는 get에서 태그를 전혀 보지 않았다.
문서에는 이렇게 적혀 있다.
태그가 캐시 항목이 낡았다고 알려 주면,
undefined를 돌려주거나revalidate: -1로 돌려주라.
재현은 어렵지 않았다. 예제 앱에는 시간대가 다른 페이지가 두 개 있고 둘 다 같은 태그를 쓴다. /cet에서 Revalidate를 두 번 눌러도 /gmt는 첫 값에 멈춰 있었다. 로그에는 cache handler hit이 찍혔다. 버튼을 누른 그 인스턴스에서도 마찬가지였고, 캐시가 만료되는 한 시간 뒤까지 옛 값이 나갔다.
get에서 태그 시각을 확인하도록 임시 패치를 넣고 다시 돌렸다.
/cet에서 무효화한 뒤 | CET | GMT |
|---|---|---|
| 원래 코드 | 갱신됨 | 07:18:58에 멈춤 |
| 태그 확인 추가 | 갱신됨 | 07:31:30 → 07:31:43 |
이 내용을 PR에 올리면서 물었다. 이 PR에 넣을지, 따로 낼지.
답은 이랬다.
let's fix it all here — this one example is important, make sure you ran a bunch of tests/benchmarks too
세 가지를 고쳤다
// Next.js는 `getExpiration`에 경로의 소프트 태그만 넘긴다. 그래서 캐시 자신의 // 태그(`cacheTag`로 붙인 것)는 여기서 확인한다. 이 캐시가 만들어진 뒤에 태그가 // 무효화됐다면 — 이 인스턴스에서든 다른 인스턴스에서든 — 낡은 캐시다. if (data.tags.length) { let revalidatedAt; try { revalidatedAt = await redis.mGet(data.tags.map((tag) => TAG_PREFIX + tag)); } catch (error) { // 태그 시각을 못 읽으면 판단할 수 없으니 내보내지 않는다. return undefined; } if (revalidatedAt.some((time) => time !== null && Number(time) > data.timestamp)) { return undefined; } }
비교 방식은 기본 핸들러와 똑같이 맞췄다(expiredAt > timestamp).
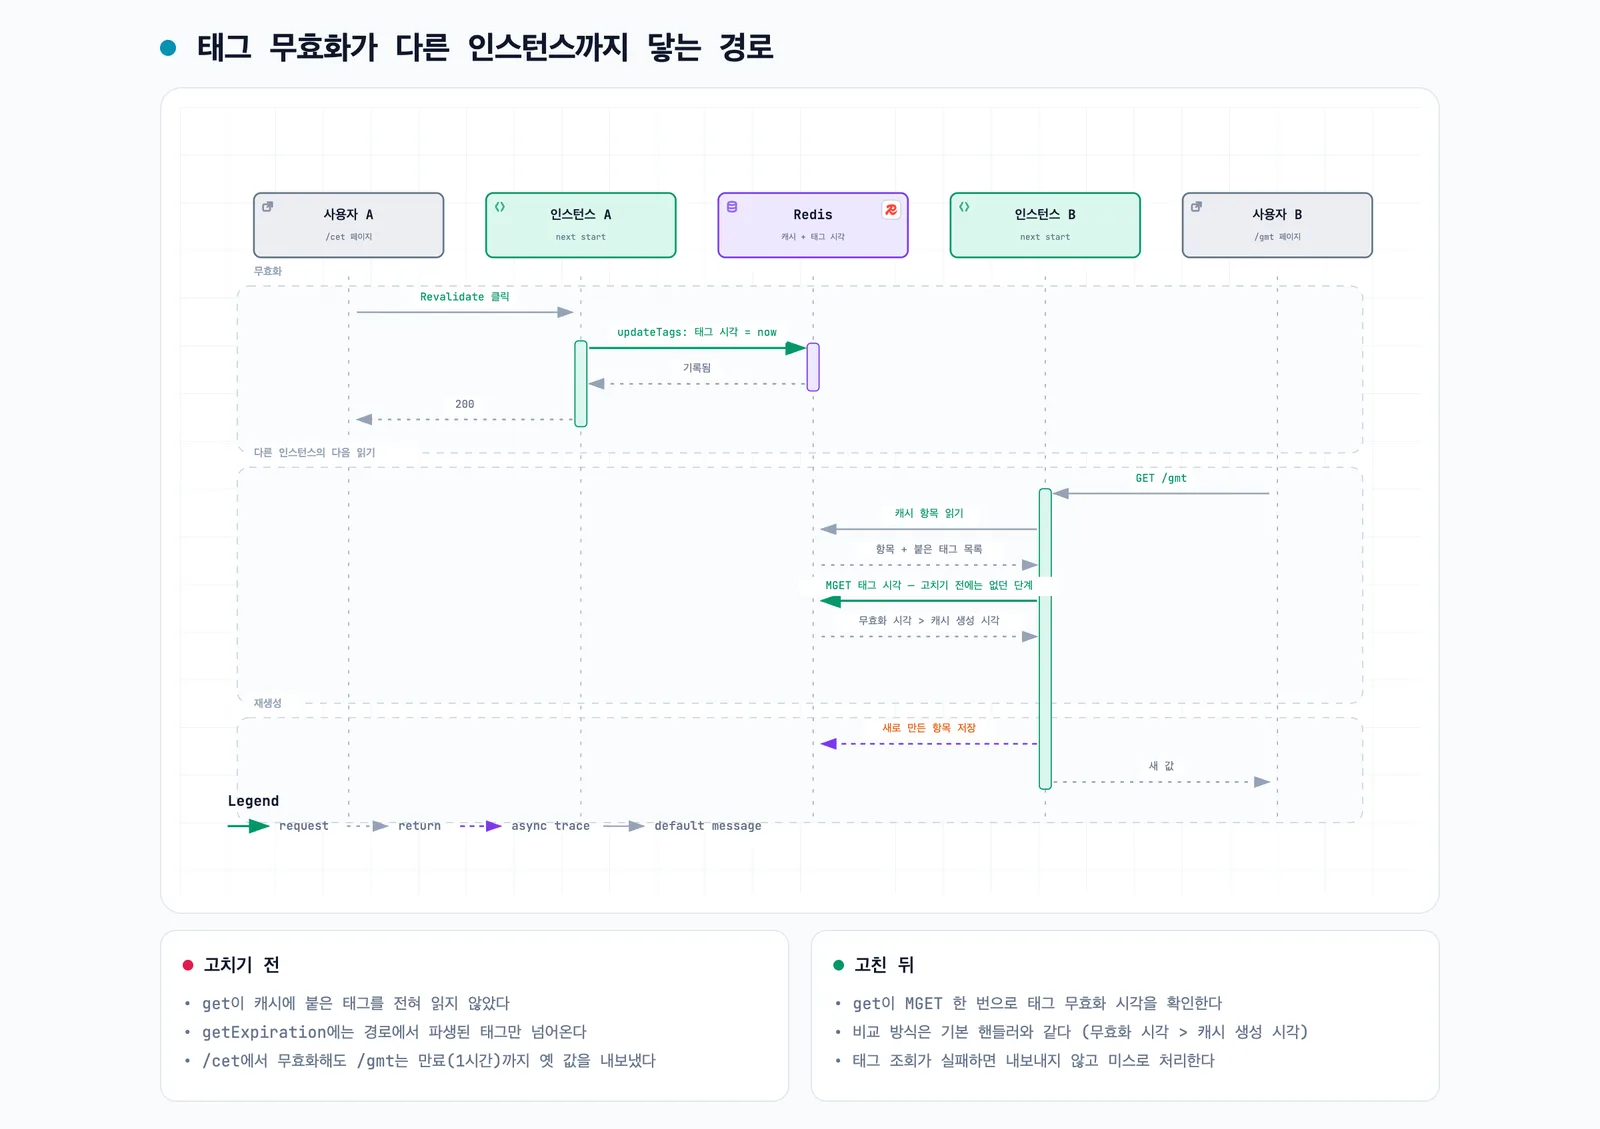
MGET 한 번이 늘었다. 고치기 전에는 이 단계가 없어서, 다른 인스턴스는 무효화를 영영 몰랐다. 나머지 둘은 이렇다. getExpiration은 Redis가 답하지 못하면 Date.now()를 돌려준다. 그러면 Next.js가 캐시를 버리고 다시 만든다. 0을 돌려주는 것과 정반대 방향이다. 그리고 Redis가 준비되지 않았을 때 updateTags와 revalidateTag는 조용히 넘어가지 않고 예외를 던진다.
durations는 건드리지 않았다. README에 "의도적으로 무시한다"고 명시돼 있어서, 고칠 것과 설계 선택을 섞지 않았다.
테스트와 벤치마크
"테스트와 벤치마크를 돌렸는지 확인하라"는 요청이 있었으니 그대로 했다. next@16.3.5(최신 안정)와 16.4.0-canary.35 두 버전에서, 고치기 전 코드와 고친 코드를 같은 스크립트로 비교했다.
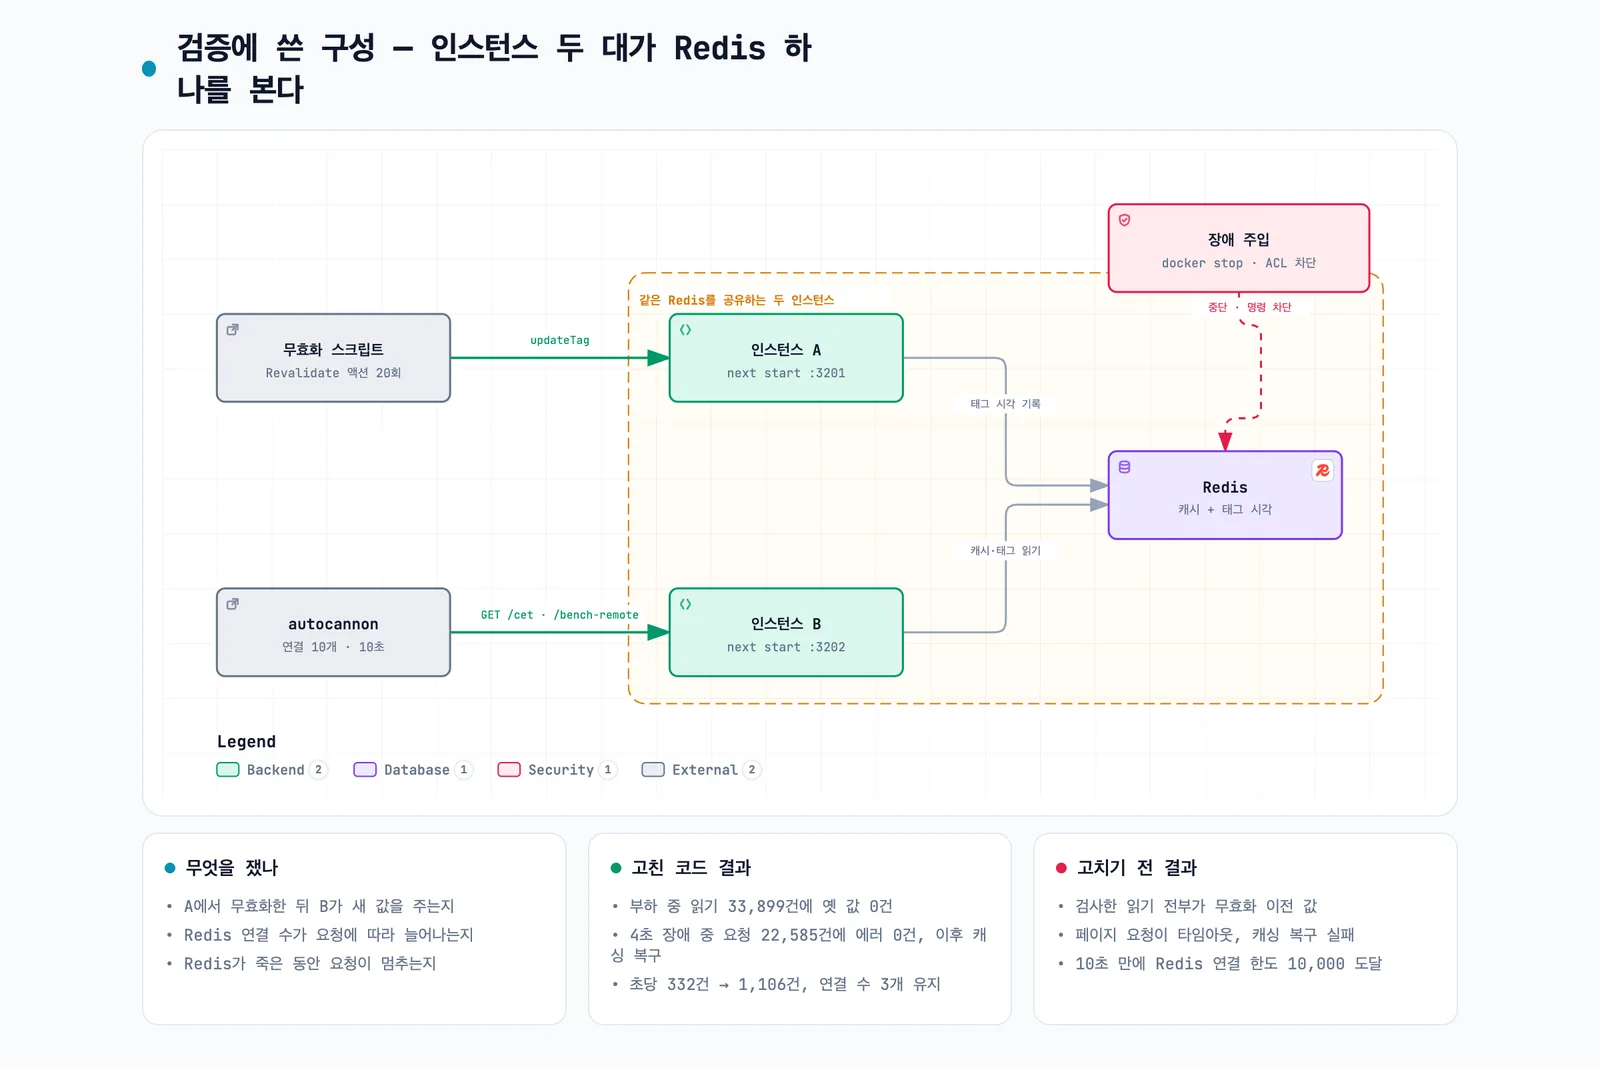
한쪽에서 무효화하고 다른 쪽에서 읽는다. 부하를 거는 동안 Redis를 내리거나 특정 명령만 막았다.
인스턴스 두 대 통합 테스트. 한쪽에서 무효화하고 다른 쪽에서 읽는 식으로 20개 항목. 고친 코드는 두 버전에서 각각 3회 반복해 전부 통과했고, 원래 코드는 10개가 실패했다.
핸들러 단위 테스트 28개. 태그가 여러 개일 때 하나만 무효화된 경우, 태그가 없는 캐시, 만료된 캐시, INFINITE_CACHE 만료값, 망가진 JSON, Redis에 닿지 않는 상태. 여기서는 Redis ACL로 특정 명령만 막아서 실패를 주입했다. MGET만 막으면 태그 조회만 실패하는 상황이 그대로 재현된다. 고친 코드 28/28, 원래 코드 14/28.
부하 중 일관성. 한쪽 인스턴스에 요청을 계속 보내면서 다른 쪽에서 무효화를 20번 했다. 무효화가 끝난 뒤에 시작된 요청이 무효화 이전 값을 받으면 위반으로 셌다. 고친 코드는 읽기 33,899건 중 위반 0건, 원래 코드는 검사 대상 전부가 위반이었다. 덤으로, 무효화 20번에 새로 만들어진 값이 정확히 20개였다. 같은 캐시를 여러 번 다시 만들지 않는다는 뜻이다.
Redis 4초 장애. 부하를 거는 도중에 Redis를 내렸다 올렸다. 고친 코드는 요청 22,585건에 에러 0건이었고 장애가 끝나자 캐싱이 돌아왔다. 원래 코드는 페이지 요청이 타임아웃에 걸렸고 캐싱이 복구되지 않았다.
벤치마크는 autocannon으로 쟀다.
/cet (연결 10개, 10초) | 원래 코드 | 고친 코드 |
|---|---|---|
16.3.5 | 초당 332건, p99 50ms, 매 실행 Redis 연결 한도 도달 | 초당 1,106건, p99 20ms, 연결 3개 |
16.4.0-canary.35 | 초당 111~332건 | 초당 1,204건, p99 13ms, 연결 3개 |
여기서 이상한 값이 몇 번 나왔다. 고친 코드인데 초당 27건으로 떨어진 실행이 있었다. 원인을 찾을 때까지 결과를 쓰지 않기로 하고 파고들었더니, 그 실행에서는 서버가 Redis에 아예 연결되지 않은 상태였다. 직전에 돌린 원래 코드가 연결을 수천 개 열었다 닫는 바람에 Docker의 포트 전달이 잠시 막힌 것이었다. 측정 전에 "서버가 실제로 연결됐는가"를 확인하고, 안 됐으면 그 실행을 무효로 표시하도록 스크립트를 고친 뒤 다시 쟀다.
비용을 숨기지 않았다
태그 확인은 공짜가 아니다. 캐시가 적중할 때마다 Redis 왕복이 한 번 늘어난다. 최악의 경우를 따로 쟀다. remote 캐시를 한 번 읽는 것 말고는 아무것도 하지 않는 라우트에서, 처리량이 9~13% 떨어졌다. 핸들러만 떼어내 재면 get의 p50이 0.34ms에서 0.65ms가 된다.
이 숫자를 그대로 PR에 적고, 왕복을 없애는 대안(refreshTags에서 요청당 한 번만 태그 시각을 읽어 두고 로컬에서 비교하는 방식)도 같이 제시한 뒤 선택을 리뷰어에게 넘겼다. 예제가 지금 로컬 태그 상태를 전혀 두지 않는 설계라 단순한 쪽을 택했다고 이유를 적었다.
숨겼다면 리뷰에서 나왔을 테고, 그때는 신뢰가 깎인 상태에서 설명해야 했을 것이다.
머지
리뷰어는 승인하면서 자기가 로컬에서 확인한 목록을 적었다.
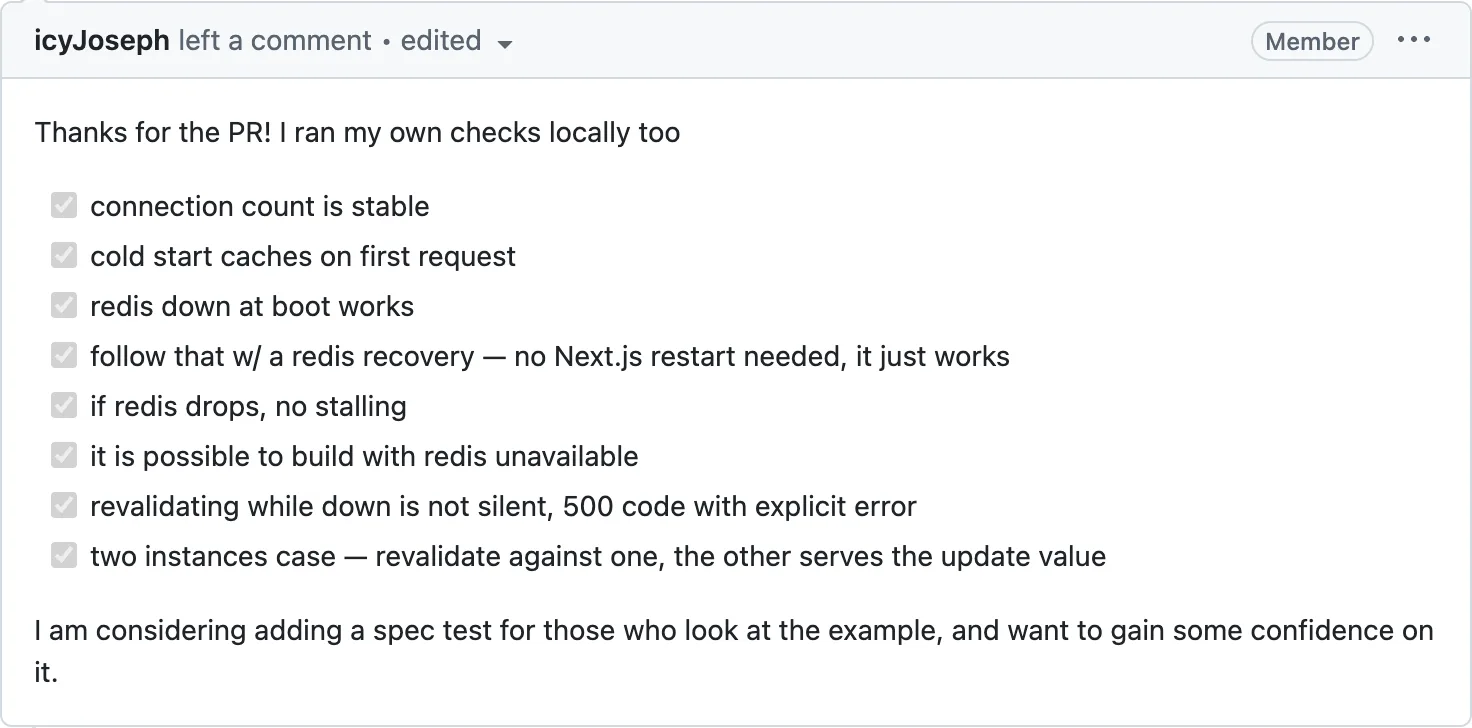
- 연결 수가 안정적이다
- 콜드 스타트에서 첫 요청에 캐시가 만들어진다
- Redis 없이 부팅해도 동작한다
- 이어서 Redis가 살아나면 Next.js 재시작 없이 그냥 된다
- Redis가 끊겨도 멈추지 않는다
- Redis 없이 빌드할 수 있다
- 중단 중 무효화가 조용히 넘어가지 않고 500과 명시적 에러를 낸다
- 인스턴스 두 대에서, 한쪽에서 무효화하면 다른 쪽이 갱신된 값을 준다
그리고 이렇게 덧붙였다.
예제를 보는 사람들이 신뢰를 가질 수 있도록, 이것들에 대한 spec 테스트를 추가하는 걸 고려하고 있다.
같은 날 머지됐다.
배운 것
공식 예제는 검증된 코드가 아니다. 문서와 예제는 "이렇게 쓰면 된다"는 안내지, "이대로 돌려도 안전하다"는 보증이 아니다. 예제를 그대로 복사해 프로덕션에 올렸다면 연결 한도에 닿거나, Redis가 잠깐 죽었을 때 서비스 전체가 멈췄을 것이다.
리뷰어의 짧은 질문을 가볍게 넘기지 않는 게 좋다. "revalidate 메서드도 버린 거지?"라는 한 줄에서 시작해 오류 처리를 다시 설계했고, 봇의 부정확한 지적을 확인하려다 훨씬 큰 버그를 찾았다. 둘 다 처음에는 "아닌데요"로 끝낼 수 있는 상황이었다.
주장 대신 재현을 보낸다. 연결 수는 client list | wc -l로, 멈춤은 curl -m 60으로, 무효화 누락은 페이지 두 개의 시각 차이로 보여줬다. 숫자가 먼저 있으면 대화가 "그게 맞나요"에서 "그럼 어떻게 고칠까요"로 바로 넘어간다.
불리한 수치를 먼저 꺼낸다. 태그 확인으로 처리량이 떨어지는 건 이 PR의 약점이다. 먼저 재서 먼저 올리면 그건 리뷰어와 함께 판단할 설계 선택이 된다.